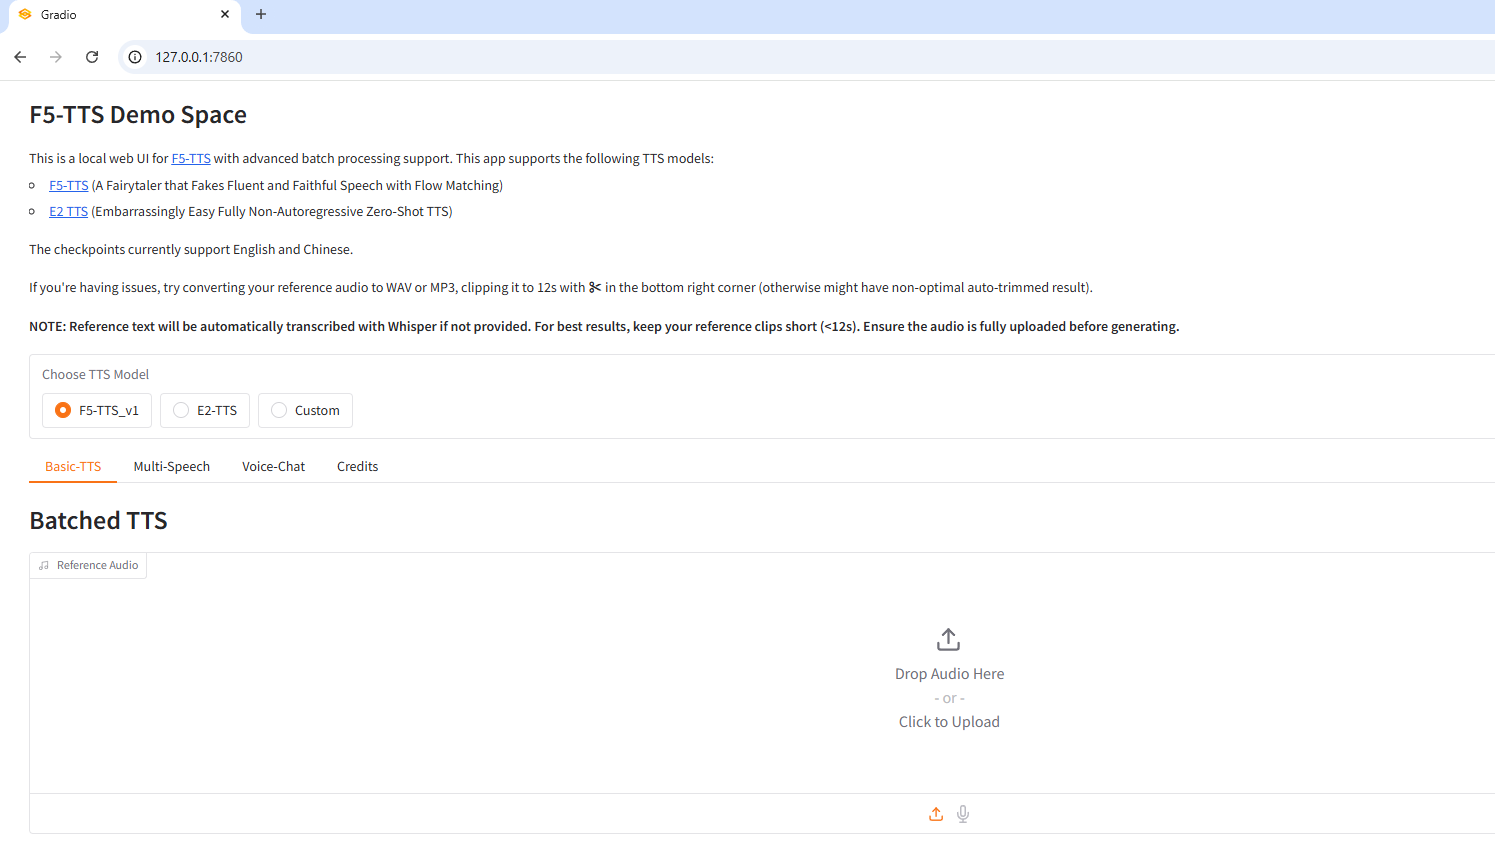
Cài đặt SWivid/F5-TTS bằng Conda
Giới thiệu
F5-TTS là một hệ thống tổng hợp giọng nói từ văn bản dựa trên phương pháp khớp luồng, tạo ra giọng nói chất lượng cao từ văn bản đầu vào. Hệ thống này triển khai phương pháp khớp luồng có điều kiện (Conditional Flow Matching - CFM) với kiến trúc dựa trên bộ biến đổi để tạo ra giọng nói tự nhiên với khả năng sao chép giọng nói.
| Mô hình | Kiến trúc | Cấu trúc chính | Mô tả |
|---|---|---|---|
| F5-TTS | Bộ chuyển đổi khuếch tán | DiT, MMDiT |
Dựa trên ConvNeXt V2, tối ưu hóa tốc độ |
| E2-TTS | Bộ chuyển đổi Flat-UNet | UNetT |
Bản sao chính xác của bài báo E2-TTS |
GitHub: https://github.com/swivid/f5-tts
Hugging Face: https://hf.co/SWivid/F5-TTS
Paper: https://hf.co/papers/2410.06885
Demo: https://hf.co/spaces/mrfakename/E2-F5-TTS
Yêu cầu hệ thống
- Hệ điều hành: Windows 10/11 (64-bit), macOS hoặc Linux (Debian/Ubuntu).
- Python: Yêu cầu phiên bản 3.12
- Dung lượng ổ cứng: Khuyến nghị 6GB trở lên (cho các thư viện phụ thuộc và bộ nhớ cache mô hình). Ít nhất 400 MB cho Miniconda; 3 GB trở lên cho Anaconda đầy đủ.
- GPU: là tùy chọn nhưng RẤT KHUYÊN DÙNG để tăng hiệu suất
- Internet: Để tải xuống các thư viện phụ thuộc và mô hình từ Hugging Face Hub.
| Mức yêu cầu | CPU | RAM |
|---|---|---|
| Tối thiểu | Intel Core i3 hoặc AMD Ryzen 3 | 8 GB |
| Khuyến nghị | Intel Core i5 hoặc AMD Ryzen 5 | 16 GB |
| Hiệu năng cao | Intel Core i7/i9 hoặc AMD Ryzen 7/9 | 32 GB |
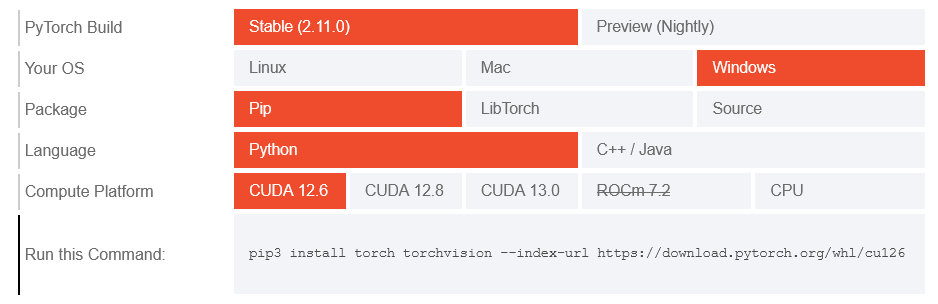
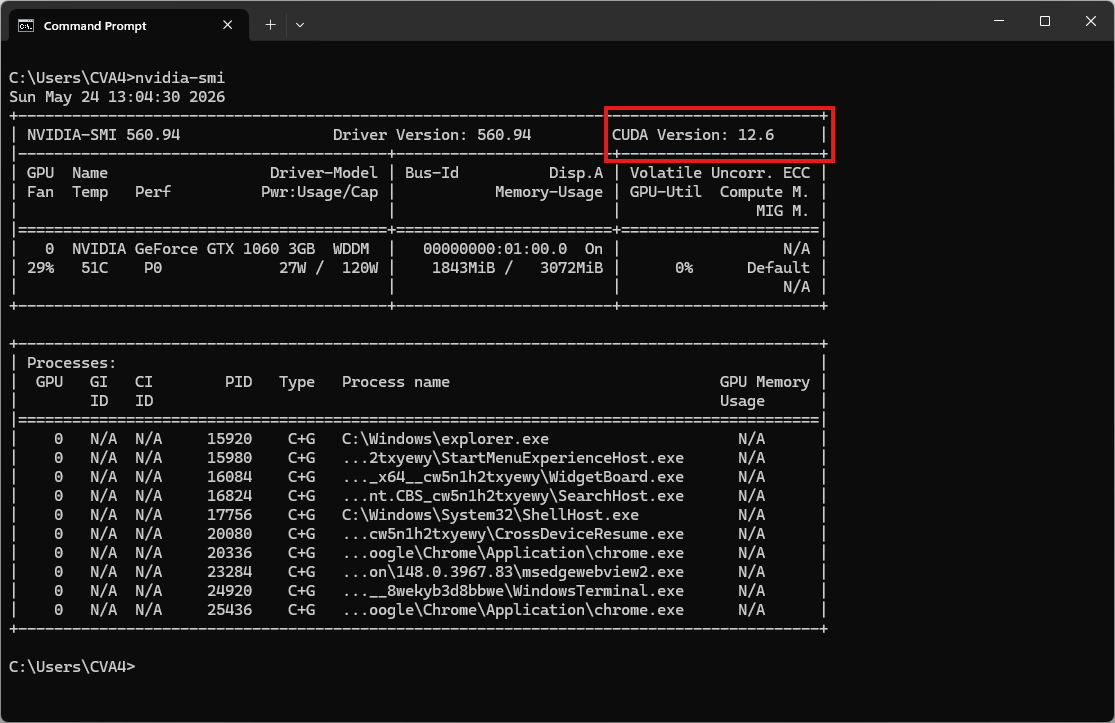
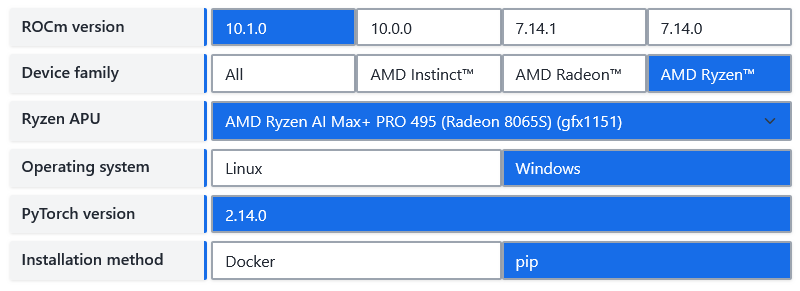
| Environment | Run this Command |
|---|---|
| CPU only | pip3 install torch torchvision |
| Apple Silicon | pip3 install torch torchvision |
| AMD ROCm | Install PyTorch for ROCm |
| CUDA 11.8 | pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118 |
| CUDA 12.1 | pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121 |
| CUDA 12.6 | pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu126 |
| CUDA 12.8 | pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu128 |
| CUDA 13.0 | pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu130 |
Video hướng dẫn
Bước 1. Cài đặt Miniconda
Tải xuống Miniconda: https://www.anaconda.com/download/success?reg=skipped
Liên kết trực tiếp: https://anaconda.com/api/installers/Miniconda3-latest-Windows-x86_64.exe
Liên kết trực tiếp: https://repo.anaconda.com/miniconda/Miniconda3-latest-Windows-arm64.exe
Cài đặt Miniconda trên Windows
Bước 2. Tạo môi trường Conda
Tạo tệp environment.yml:
name: f5-tts
channels:
- conda-forge
- defaults
dependencies:
# Python version >= 3.10 required
- python=3.11

# Install FFmpeg if you haven't yet
- ffmpeg

- pip
- pip:
    # PyTorch CPU only
    - torch
    - torchaudio

    # Allow run Gradio app (web interface)
    - gradio

    # F5-TTS
- f5-ttsKích hoạt môi trường conda:
conda env create -f environment.yml
conda activate f5-tts
Lưu ý: RuntimeWarning: Couldn't find ffmpeg or avconv - defaulting to ffmpeg, but may not work có thể được bỏ qua nếu bạn chỉ làm việc với các tệp âm thanh định dạng WAV, vì Pydub hỗ trợ đọc và ghi tệp WAV mà không cần đến FFmpeg. Tuy nhiên, FFmpeg là bắt buộc nếu bạn muốn xử lý các định dạng âm thanh khác như MP3, OGG, FLAC, hoặc thực hiện chuyển đổi định dạng âm thanh.
Bước 3. Chạy suy luận
CLI Inference
Mẫu âm thanh tham khảo:
# Run with flags
# Leave --ref_text "" will have ASR model transcribe (extra GPU memory usage)
f5-tts_infer-cli --model F5TTS_v1_Base \
--ref_audio "D:\f5-tts\ref_audio.wav" \
--ref_text "The piper was very glad to see the pig and said to Tom" \
--gen_text "Some text you want TTS model generate for you."
Kết quả sẽ là tệp âm thanh tests\infer_cli_basic.wav
Chạy app demo bằng Gradio (web interface)
# Launch a Gradio app (web interface)
f5-tts_infer-gradio
Starting app…
- Running on local URL: http://127.0.0.1:7860